Google DeepMind Genie 4 정리: 소리까지 만드는 실시간 월드 모델과 3D 제작자에게 주는 뜻
Google DeepMind가 발표한 월드 모델 Genie 4의 새 기능, Genie 3과 달라진 점, 공개 일정과 한계를 공식 발표만으로 정리하고, Blender·게임 제작자에게 어떤 뜻인지 짚어 봅니다.
한국어English
기준: Google DeepMind 블로그 "Genie 4: A new generation of world simulation"(2026년 10월 27일 발표), 같은 블로그의 Genie 3 발표 글(2025년), Google 블로그의 Project Genie 안내 글(2026년). 2026년 10월에 확인했습니다. Genie 4는 아직 신뢰 테스터에게만 열려 있어 직접 써 보지 않았습니다. 이 글은 공식 발표만 정리했습니다. 그림은 발표 페이지 캡처와 DeepMind 공식 시연 영상에서 뽑은 정지 화면입니다.
Genie 4는 글 한 줄과 키보드만으로 움직이는 "살아 있는 장면"을 실시간으로 만들어 내는 AI입니다. Google DeepMind가 새로 발표한 월드 모델(world model)이고, 이번에는 그림뿐 아니라 바람 소리, 악기 소리, 사람의 대화까지 함께 만듭니다. 장면 속을 걸어 다니다가 "수박 위에 대리석 흉상을 떨어뜨려"라고 쓰면, 그다음 일이 화면에서 이어집니다.
Blender나 게임 엔진으로 장면을 만드는 사람에게는 "이게 내 일을 대신하나"가 먼저 궁금할 것입니다. 발표를 읽어 보면 답은 생각보다 분명합니다. Genie 4가 만드는 것은 움직이는 화면(픽셀) 이고, 발표 어디에도 3D 모델 파일을 내보낸다는 말은 없습니다. 이 글에서는 발표에 나온 새 기능, Genie 3과 달라진 점, 공개 일정과 한계를 차례로 설명하고, 마지막에 3D 제작자에게 어떤 뜻인지를 짐작과 사실을 나눠 정리합니다.
 Genie 4 발표 페이지 첫 화면. 제목 아래 대기 명단 신청 단추 (Google DeepMind 블로그 화면 캡처)
한눈에 보는 Genie 4 발표
| 항목 | 발표 내용 |
|---|---|
| 무엇 | 새 월드 모델. 장면, 소리, 사람의 움직임과 말을 실시간으로 함께 만듦 |
| 바탕 | Gemini 모델 계열의 능력 위에 지음. Gemini Omni가 실제 세상의 겉모습과 움직임을 맞추고, 다른 Gemini 모델이 장면이 앞뒤로 어긋나지 않게 추론을 맡음 |
| 조작 | 키보드로 걷기와 카메라 돌리기, 글(프롬프트)로 장면 바꾸기 |
| 새로 강조한 것 | 실시간 장면 바꾸기, 물리와 사람의 움직임, 소리, Gemini가 이끄는 여러 단계 사건 |
| 지금 쓸 수 있는 사람 | 신뢰 테스터(연구 미리보기) |
| 다음 공개 대상 | Project Genie의 Google AI Ultra 구독자, Gemini API·Google AI Studio 조기 이용 파트너. "곧"이라고만 하고 날짜는 밝히지 않음 |
| 밝히지 않은 것 | 해상도, 초당 화면 수, 한 번에 이어지는 시간, 가격, 출시 날짜, 3D 파일 내보내기 |
월드 모델이라는 말
월드 모델은 "지금 장면에서 다음에 무슨 일이 일어날지"를 그려 내는 AI입니다. 게임 엔진과 비교하면 차이가 잘 보입니다.
- 게임 엔진은 사람이 만든 3D 모델, 재질, 물리 규칙을 넣어 두고 매 순간 계산해 화면을 그립니다.
- 월드 모델은 그런 재료 없이, 지금까지의 화면과 여러분의 입력(키보드, 글)을 보고 다음 화면을 바로 그려 냅니다.
비유하면 게임 엔진은 세트를 미리 지어 놓은 촬영장이고, 월드 모델은 관객이 "왼쪽으로 가 볼래요"라고 말하는 순간 그쪽 풍경을 즉석에서 그려 주는 화가입니다. 세트가 없으니 무엇이든 그릴 수 있지만, 오래 그리다 보면 아까 그린 문의 위치가 조금씩 달라질 수 있습니다. 이 약점은 뒤의 "한계" 절에서 다시 나옵니다.
DeepMind는 Genie 4가 로봇과 AI 에이전트를 훈련할 환경을 만드는 일부터 새로운 상호작용 경험을 만드는 일까지 쓰일 수 있다고 설명합니다. 에이전트(agent)는 대답만 하는 AI가 아니라 스스로 단계를 밟아 일을 해 나가는 AI를 말합니다.
새 기능 1: 글로 장면을 실시간으로 바꾸기
발표 페이지의 시연 영상 여러 개는 실시간 조작을 녹화한 것이라고 적혀 있습니다. 화면 왼쪽 아래에 W A S D 키, 오른쪽 아래에 화살표 키가 보이고, 가운데 아래에 글을 넣는 칸이 있습니다. 걷기와 카메라는 키보드로, 장면 바꾸기는 글로 합니다.
예로 든 것은 날씨 바꾸기, 카메라 옮기기, 새 사람이나 물체 넣기입니다. 여러분이 쓴 글을 Gemini가 주변 장면에 맞게 다듬어 넘기고, 여러분이 아무것도 입력하지 않는 동안에도 Gemini가 장면을 지켜보며 이야기가 자연스럽게 이어지도록 이끈다고 합니다.
아래 두 그림은 같은 시연 영상의 앞과 뒤입니다. 첫 그림에서 입력 칸의 글을 먼저 읽고, 둘째 그림에서 그 글이 장면에 어떻게 반영됐는지 보세요.
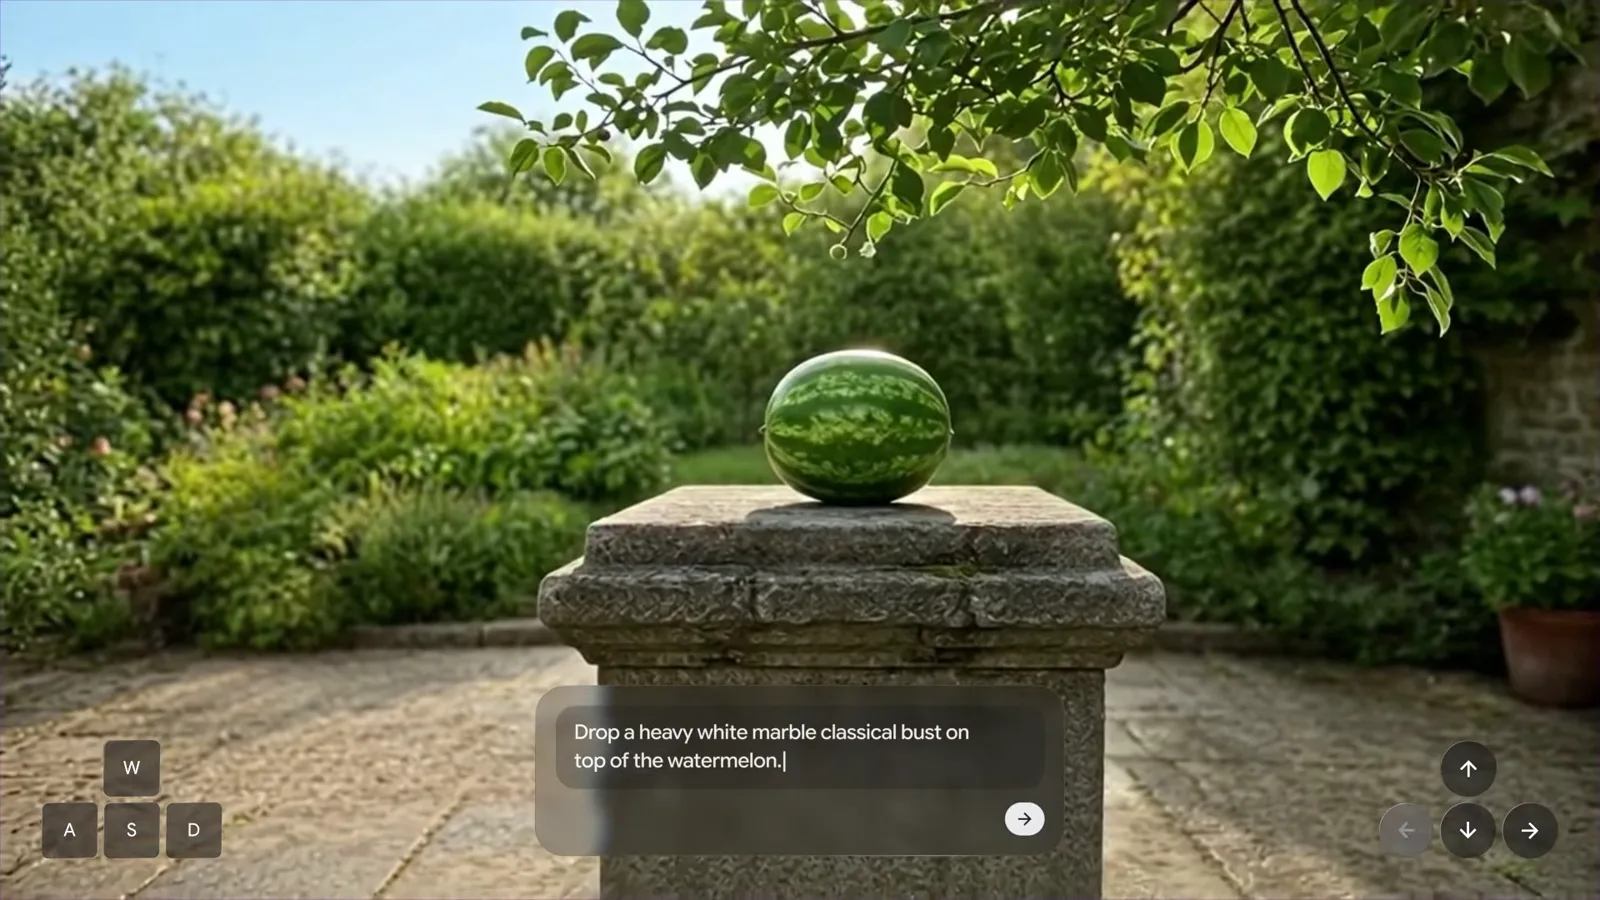 바꾸기 전. 입력 칸의 글은 "무거운 흰 대리석 흉상을 수박 위에 떨어뜨려" (Google DeepMind 공식 시연 영상 정지 화면)
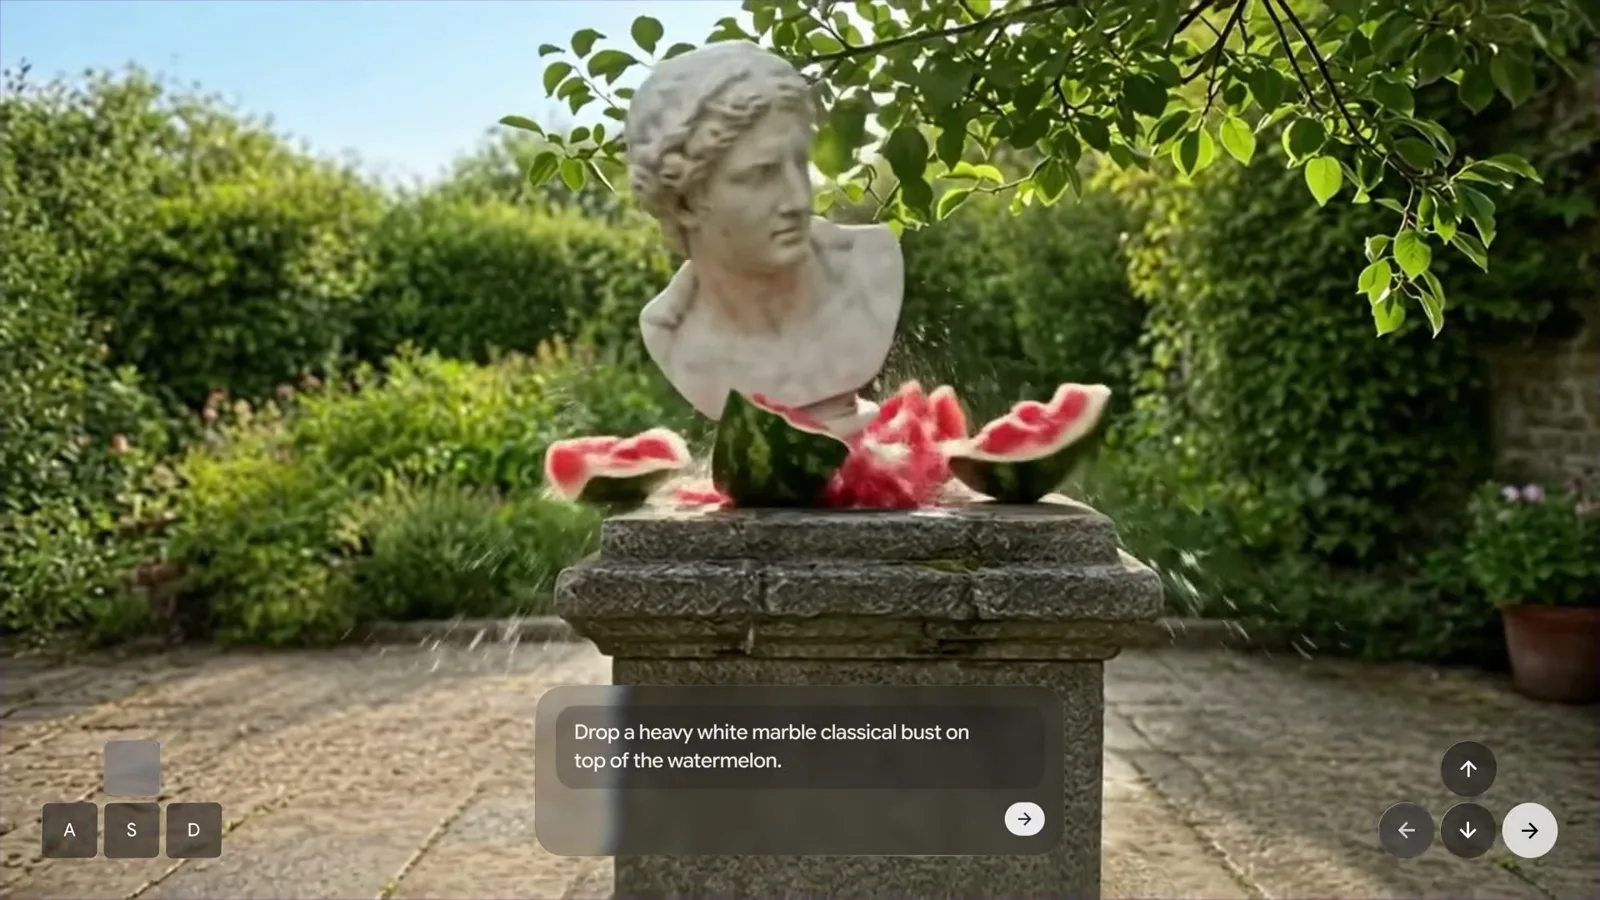 바꾼 뒤. 흉상이 떨어지며 수박이 깨지고 조각과 물방울이 튐 (Google DeepMind 공식 시연 영상 정지 화면)
이 장면에서 볼 점은 두 가지입니다. 하나는 글 한 줄이 "물체 넣기"와 "그 물체가 떨어지는 사건"을 한 번에 일으켰다는 것입니다. 다른 하나는 수박이 깨지고 조각이 튀는 결과까지 모델이 이어서 그렸다는 것입니다. Blender라면 흉상 모델, 수박 파괴 시뮬레이션, 물방울 입자를 따로 준비해야 하는 장면입니다.
새 기능 2: 물리와 사람의 움직임
DeepMind는 Genie 4가 공기의 흐름(공기역학), 부딪힘(충돌) 같은 물리 상황을 흉내 낸다고 소개합니다. 시연에는 단풍나무 씨앗이 나무에서 풀밭으로 떨어지는 모습을 가까이 찍은 장면, 위의 수박 장면이 있습니다.
"가장 극적인 도약"으로 꼽은 것은 사람입니다. 사람이 자연스럽게 움직이고, 주변에 반응하고, 실시간으로 조종할 수 있다고 합니다.
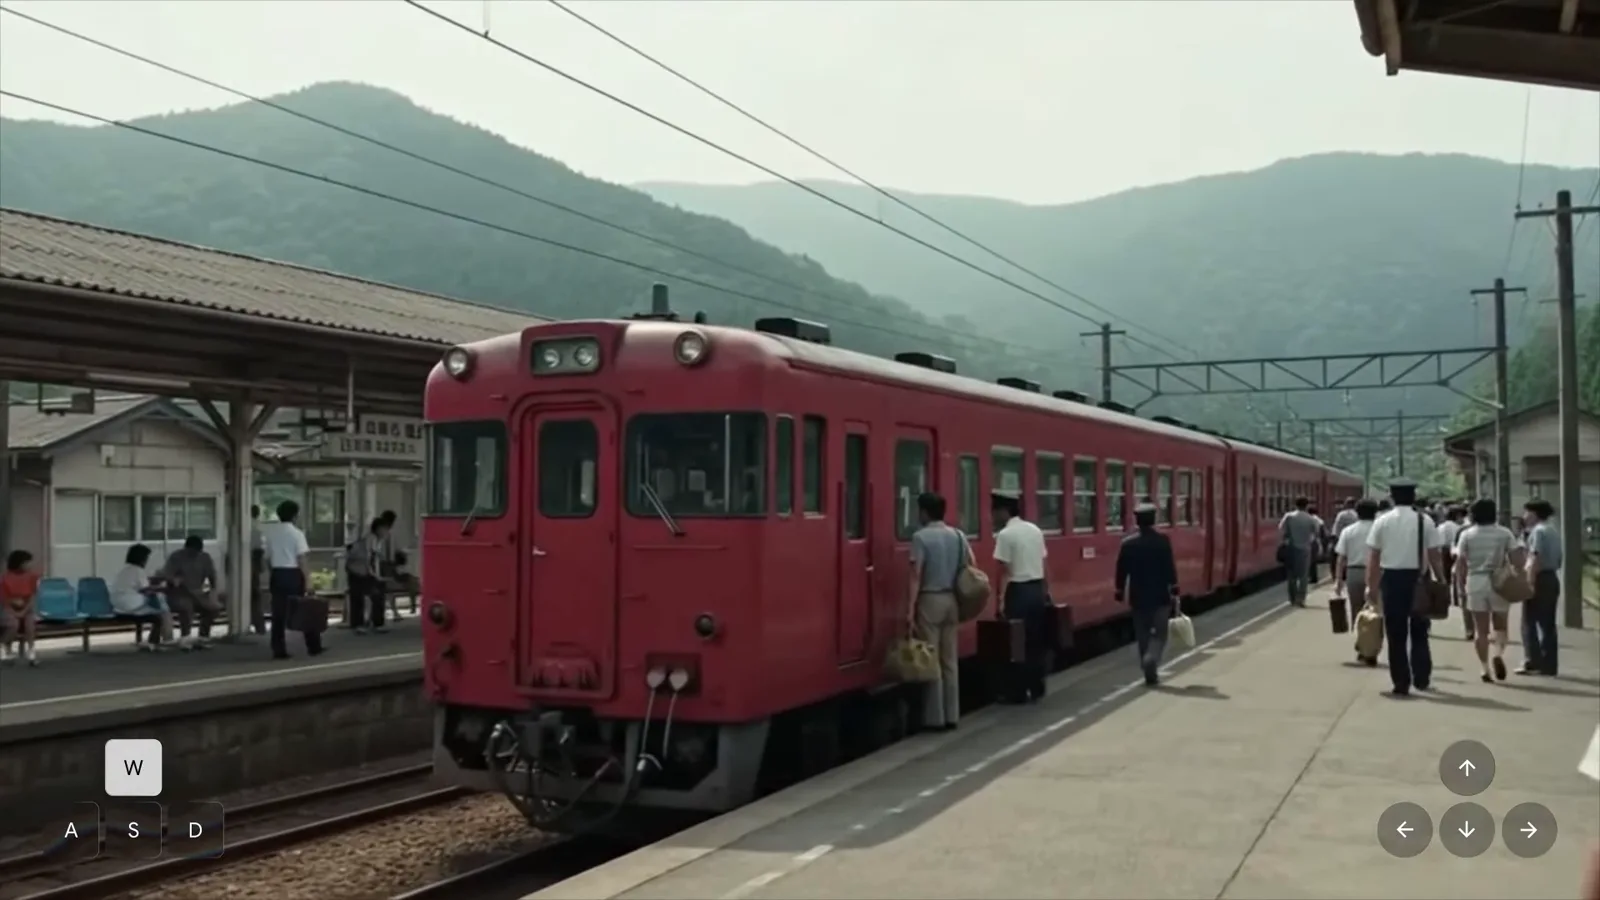 1980년대 일본 시골 기차역을 요청한 시연. 승강장의 사람들이 각자 걷고 기차에 오름 (Google DeepMind 공식 시연 영상 정지 화면)
그림에서 사람들의 자세와 걸음이 저마다 다른 것을 보세요. 반대로 왼쪽 위 역 간판의 글자는 읽을 수 없게 뭉개져 있습니다. "읽을 수 있는 글자 그리기"는 공식 한계 목록에도 연구 중인 과제로 올라 있습니다. 화면 속 간판, 책 표지, 화면 글씨가 중요한 장면이라면 지금은 기대하지 않는 편이 맞습니다.
새 기능 3: 장면이 내는 소리
DeepMind는 Genie 4를 "소리를 직접 만들어 내는 첫 실시간 월드 모델"이라고 소개합니다(자사 모델 가운데 처음이라는 뜻). 숲이면 나뭇잎을 흔드는 바람 소리, 바닷가면 파도 소리가 장면과 함께 나옵니다.
더 큰 걸음으로 꼽은 것은 사람의 말입니다. 장면 속 인물이 서로 대화하고, 여러분의 입력이나 장면 속 사건에 맞춰 말을 바꾼다고 합니다. 발표 첫머리 영상들의 소리는 모두 Genie 4가 직접 만든 것이라고 적혀 있습니다. 소리는 그림으로 옮길 수 없으니, 발표 페이지에서 영상의 소리를 켜고 들어 보세요.
다만 실시간 소리의 정확도는 아직 연구 중인 과제로 남아 있습니다.
새 기능 4: Gemini가 이끄는 여러 단계 사건
Genie 4는 혼자 돌지 않습니다. Gemini 3.8 Flash가 옆에서 안내 에이전트 역할을 합니다. 하는 일은 셋입니다.
- 목표를 여러 단계로 나눕니다.
- Genie 4가 새로 그린 화면을 보며 단계가 제대로 이뤄졌는지 확인합니다.
- 장면이 바뀌거나 사용자가 끼어들면 계획을 그 자리에서 고칩니다.
촬영장에 빗대면 Genie 4는 화면을 그리는 카메라 팀이고, Gemini는 콘티를 들고 "이 컷 됐다, 다음 컷"을 외치는 조감독입니다.
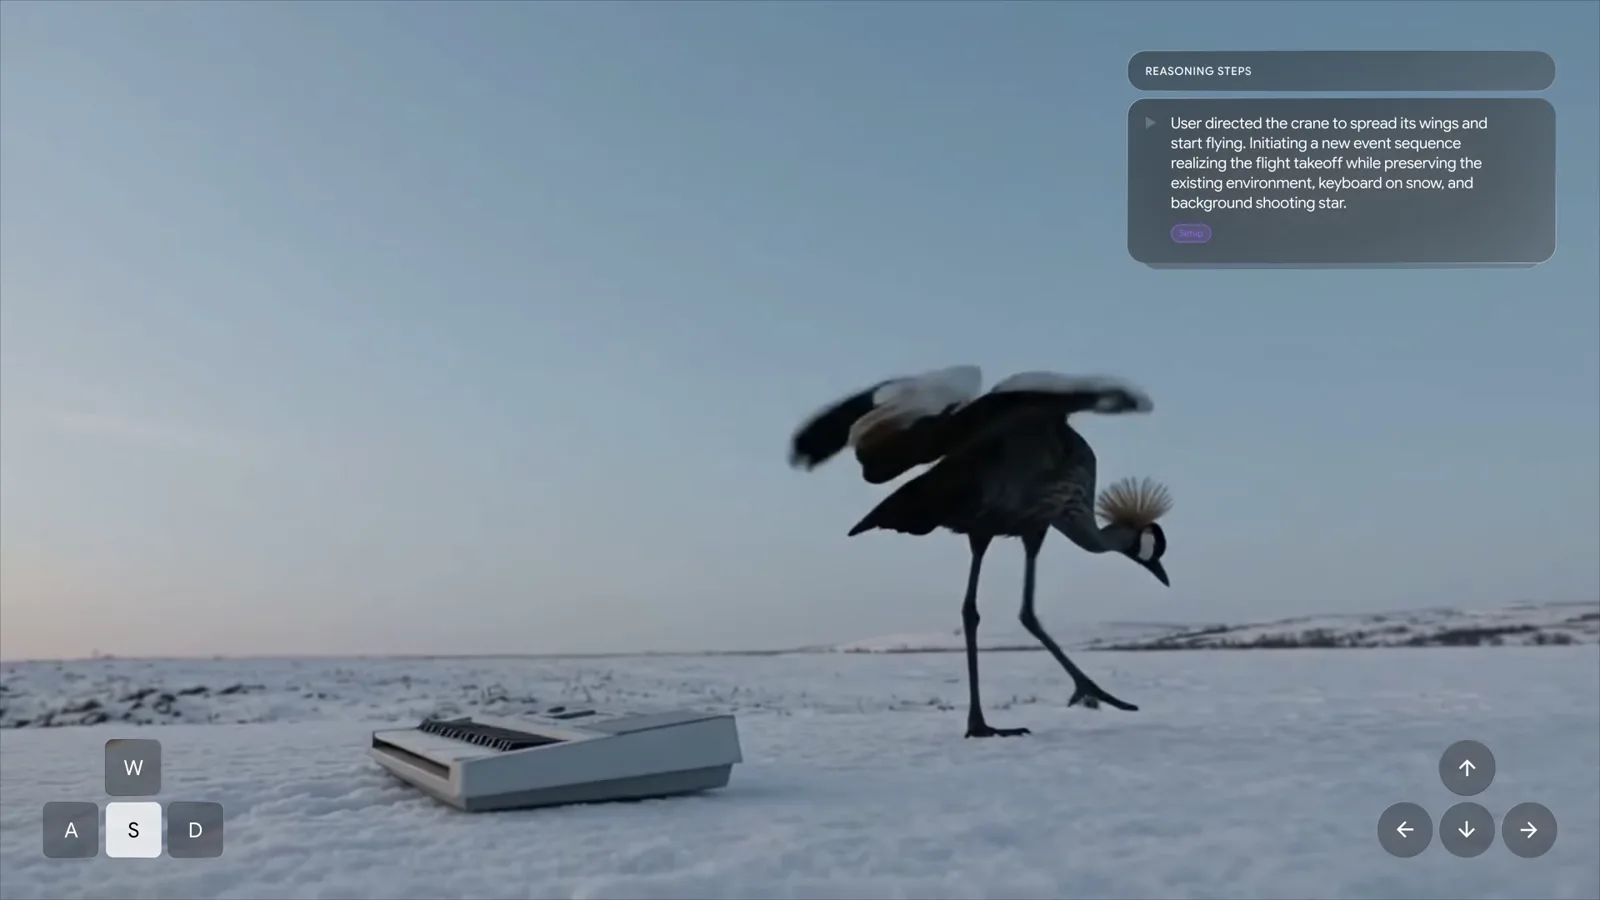 오른쪽 위 REASONING STEPS(추론 단계) 상자. 사용자가 두루미에게 날개를 펴고 날라고 지시해, 배경은 그대로 둔 채 이륙 사건을 새로 시작한다는 설명 (Google DeepMind 공식 시연 영상 정지 화면)
그림 오른쪽 위 상자를 읽어 보세요. "사용자가 두루미에게 날개를 펴고 날기 시작하라고 지시함", "눈밭, 눈 위의 키보드, 배경의 별똥별은 그대로 두고 이륙 장면을 새로 시작함"이라는 뜻의 글이 적혀 있습니다. 바꿀 것과 지킬 것을 Gemini가 먼저 정리하고, Genie 4가 그것을 그리는 구조입니다.
로봇 연구와 이은 실험도 있습니다. Gemini 4 Argon이 사용자가 준 과제를 단계로 나누고, 그 단계를 글 캡션으로 Genie 4에 끼워 넣어 시뮬레이션을 이끕니다. 예로 Apptronik의 휴머노이드 로봇 Apollo가 체커 게임을 두는 장면을 보여 줍니다.
Genie 3과 달라진 점
Genie 4 발표 글에는 Genie 3과의 수치 비교가 없습니다. 비교 자료는 두 모델의 결과를 나란히 놓은 시연 영상 하나이고, 그 영상 아래에는 "보여 주기 위한 결과이며 장면을 줄였다"는 안내가 붙어 있습니다.
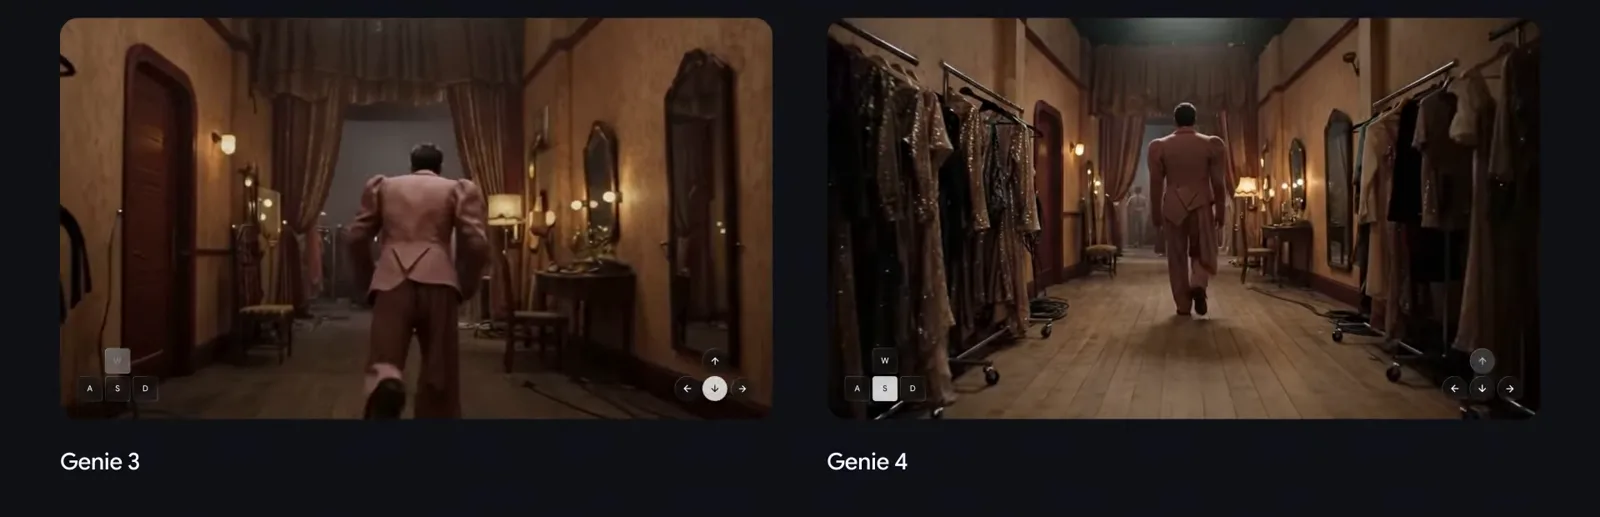 같은 무대 뒤 복도 장면의 Genie 3(왼쪽)과 Genie 4(오른쪽). 원본 영상 아래 안내 "Results for illustrative purposes. Sequences shortened." (Google DeepMind 공식 시연 영상 정지 화면)
그림에서 옷걸이의 옷, 바닥 나뭇결, 사람의 걸음 자세를 견주어 보세요. 다만 이것은 DeepMind가 고른 장면이라, 모든 장면에서 같은 차이가 난다고 볼 수는 없습니다.
공식 자료로 확인되는 차이는 아래와 같습니다.
| 항목 | Genie 3 | Genie 4 |
|---|---|---|
| 발표 | 2025년 8월 | 2026년 10월 |
| 해상도·초당 화면 수 | 720p, 초당 24장 | 발표에서 밝히지 않음 |
| 이어지는 시간 | 몇 분 동안 일관됨, 시각 기억 약 1분 | "짧은 세션"에서 일관됨. 시간은 밝히지 않음 |
| 글로 장면 바꾸기 | 있음(날씨 바꾸기, 물체·인물 넣기) | 있음. Gemini가 글을 장면에 맞게 다듬고 입력 사이에도 장면을 이끎 |
| 소리 | 발표에 없음 | 주변 소리, 음악, 대화를 함께 만듦 |
| 바탕 모델 | 발표에 없음 | Gemini Omni와 다른 Gemini 모델 |
| 공개 | 소수 연구자·창작자 대상 제한된 연구 미리보기 | 신뢰 테스터 대상 연구 미리보기 |
그보다 앞선 Genie 2는 에이전트를 훈련할 환경을 만드는 모델이었습니다. Genie 3 발표 글은 Genie 3을 "실시간으로 상호작용할 수 있는 자사 첫 월드 모델"이라고 불렀습니다. Genie 2와 Genie 4를 직접 견준 공식 자료는 찾지 못했습니다.
누가, 언제 쓸 수 있나
지금은 신뢰 테스터만 씁니다. DeepMind는 테스터의 의견을 모은 뒤 일반 사용자와 개발자에게 넓힐 계획이고, 그 첫 대상으로 아래 둘을 들었습니다.
- Project Genie를 쓰는 Google AI Ultra 구독자
- Gemini API와 Google AI Studio의 조기 이용 파트너
Project Genie는 Google이 2026년 1월에 연 실험용 웹 앱입니다. 처음 열었을 때 안내 글에는 Genie 3을 바탕으로 하고, 미국의 18세 이상 Google AI Ultra 구독자가 쓸 수 있으며, 한 번 만드는 길이가 60초로 제한된다고 적혀 있었습니다. Genie 4가 들어온 뒤의 대상 나라, 길이 제한, 요금은 이번 발표에서 밝히지 않았습니다. 쓰고 싶다면 발표 페이지 맨 위의 Join the Genie 4 waitlist 단추로 대기 명단에 이름을 올리고, 공개 소식은 공식 안내에서 확인하세요.
신뢰 테스터가 써 본 곳
DeepMind는 창작, 저널리즘, 교육, 게임, 공학 분야의 신뢰 테스터와 함께 Genie 4를 시험했다고 밝혔습니다. 소개된 쓰임은 넷입니다.
| 분야 | 발표에 나온 쓰임 |
|---|---|
| 창작 연출 | 프리비즈(사전 시각화)와 아이디어 잡기용 "초안 모드". 영화인이 시뮬레이션 안에 들어가 카메라 각도, 조명, 대사, 동작을 바꿔 가며 여러 번 찍어 보기 |
| 역사·사진 | 기록 사진 한 장을 몇 초 만에 그 장소의 시뮬레이션으로 바꾸기. 갑작스러운 홍수나 산불이 번지는 모습 그려 보기 |
| 게임·체험 기획 | 아이디어에서 돌아다닐 수 있는 시제품까지 몇 초. 엔진 코드를 쓰기 전에 그림 스타일, 재질 느낌, 조작 방식을 글로 시험하기 |
| 기업 시뮬레이션 | 아무것도 없는 상태에서 시나리오를 빠르게 만들어 보기 |
앞으로의 방향은 "하이브리드 월드 모델"입니다. 코드와 언어 모델의 짜임새 있는 추론과, 픽셀 단위로 그려 내는 시뮬레이션을 합치는 방식입니다. Gemini가 뒤에서 구조와 이야기 흐름을 짜고, Genie가 지금 눈앞의 화면과 소리를 그리는 지금의 짝이 그 첫걸음이라고 설명합니다.
안전장치와 한계
안전장치: DeepMind는 Genie 4에 다른 모델과 같은 안전 정책의 가드레일을 넣었고, 미리보기 전에 해롭거나 악의적인 결과를 막는 내부 안전 평가를 했다고 밝혔습니다. 신뢰 테스터에게 먼저 연 것은 넓게 풀기 전에 의견을 먼저 받으려는 뜻입니다. Genie 4가 만든 영상과 소리에는 모두 SynthID가 들어갑니다. SynthID는 눈과 귀로는 알아챌 수 없는 디지털 워터마크로, 나중에 AI가 만든 것인지 가려낼 때 쓰입니다. 지폐 속 숨은 무늬처럼 겉으로는 안 보여도 기계로는 읽히는 표식입니다.
한계: Genie 4는 아직 "초기 단계의 실험 모델"이고, 공식 한계는 아래와 같습니다.
- 짧은 세션에서는 장면이 일관되지만, 오래 돌리거나 복잡한 글 수정을 여러 번 하거나 장면 곳곳을 돌아다니면 세부 모습과 물체의 위치가 흔들릴 수 있습니다.
- 복잡한 물리 상호작용, 실시간 소리의 정확도, 읽을 수 있는 글자, 공간의 정확도, 오래 이어지는 일관성은 아직 연구 중입니다.
앞에서 든 "즉석 화가" 비유로 돌아가면, 아까 그린 문이 다시 돌아봤을 때 다른 자리에 있을 수 있다는 뜻입니다. 3D 장면 파일은 같은 물체가 늘 같은 자리에 있다는 점이 강점인데, Genie 4는 그 점을 아직 약점으로 갖고 있습니다.
3D 제작자에게 주는 뜻
여기서부터는 짐작이 섞여 있습니다. 아래 표는 DeepMind가 직접 말한 것과 짐작을 나눠 적었습니다.
| 우리 일 | 발표가 말한 것 | 짐작 | 걸리는 점 |
|---|---|---|---|
| 영상 프리비즈 | 영화인이 "초안 모드"로 카메라·조명·동작을 바꿔 가며 여러 번 찍어 봄 | Blender 블록아웃을 만들기 전에 구도와 분위기를 먼저 잡아 보는 용도로 쓸 만해 보임 | 물체 위치가 흔들릴 수 있어 컷 사이 연결을 맞추기 어려울 수 있음 |
| 게임 시제품 | 엔진 코드 전에 그림 스타일, 재질, 조작 방식을 글로 시험 | "이 느낌이 맞나"를 팀과 맞추는 시안 단계가 빨라질 수 있음 | 나오는 것은 화면이고, 3D 모델·레벨 파일 내보내기는 발표에 없음 |
| 최종 영상 | 언급 없음 | 지금 바로 최종 컷을 대신하기는 어려워 보임 | 글자 뭉개짐, 긴 장면의 일관성, 해상도 미공개 |
| 소리 | 장면과 함께 소리·대화를 만듦 | 프리비즈에 임시 현장음이 붙어 분위기 판단이 쉬워질 수 있음 | 소리 정확도는 연구 중 |
정리하면 Genie 4는 Blender를 대신하는 도구라기보다, Blender를 켜기 전 단계의 스케치북에 가까워 보입니다. 정확한 치수, 같은 물체를 여러 컷에서 똑같이 쓰는 일, 게임 엔진으로 넘길 파일은 여전히 3D 장면 파일이 맡습니다. 반대로 "이런 장면이면 어떨까"를 빠르게 여러 개 보는 일은 월드 모델 쪽으로 옮겨 갈 가능성이 큽니다. 이 판단은 Genie 4가 일반에 열리고 직접 써 본 뒤에 다시 확인해야 합니다.
지금 할 수 있는 준비도 있습니다.
- 장면을 글로 또렷하게 적는 연습을 해 두세요. 일부 시연 프롬프트는 "환경"과 "인물" 설명을 나누고, 여러 프롬프트가 카메라 위치와 피할 것까지 적었습니다. AI 영상 도구에 넣는 프롬프트와 같은 요령입니다.
- 블록아웃을 계속 쓰세요. 월드 모델이 그린 시안이 마음에 들어도, 같은 장면을 여러 컷으로 찍으려면 결국 물체 위치가 고정된 3D 장면이 필요합니다.
- 결과물을 쓸 때는 SynthID가 들어 있다는 점과 저작권 문제를 함께 생각하세요.
자주 하는 오해
| 오해 | 발표 내용 |
|---|---|
| Genie 3보다 해상도가 높다 | 해상도·초당 화면 수를 밝히지 않음. 비교는 나란히 놓은 시연 영상뿐 |
| 오래 돌려도 장면이 그대로다 | 오래 돌리거나 여러 번 고치면 세부와 물체 위치가 흔들릴 수 있다고 직접 적음 |
| 소리는 따로 붙인 것이다 | 발표 첫머리 영상들의 소리는 모두 Genie 4가 만들었다고 밝힘 |
한 줄 정리
Genie 4는 글과 키보드로 조종하는 실시간 장면 생성기, 이번에는 소리와 대화까지, 다만 아직 테스터 전용이고 3D 파일은 만들지 않음. 3D 제작자에게는 Blender를 켜기 전의 빠른 시안 도구가 될 가능성이 크고, 정확한 장면과 최종 작업은 여전히 3D 장면 파일의 몫입니다.
함께 읽기
- AI 영상 생성 입문: 텍스트·이미지로 영상 만들기
- AI 이미지 생성의 원리와 좋은 프롬프트
- AI로 만든 이미지·글의 저작권 기초
- AI와 Blender, 작은 작업부터 함께 시작하기
참고 자료
- Google DeepMind, Genie 4: A new generation of world simulation: https://deepmind.google/blog/genie-4-a-new-generation-of-world-simulation/
- Google DeepMind, Genie 3: A new frontier for world models: https://deepmind.google/discover/blog/genie-3-a-new-frontier-for-world-models/
- Google, Project Genie: Experimenting with infinite, interactive worlds: https://blog.google/innovation-and-ai/models-and-research/google-deepmind/project-genie/
- 그림: Google DeepMind 블로그 Genie 4 발표 페이지 캡처, 같은 페이지의 공식 시연 영상 정지 화면(저작권 Google DeepMind)