AI 영상 생성 입문: 텍스트·이미지로 영상 만들기
AI 영상은 그림 여러 장을 시간에 맞게 이어 그리는 기술입니다. 원리, 시작하는 세 가지 방법, 카메라까지 담는 프롬프트 요령을 설명합니다.
한국어English
기준: OpenAI·Google·Stability AI 공식 문서와 연구 블로그(2021년, 2023년, 2024년 글). 2026년 9월에 확인했습니다.
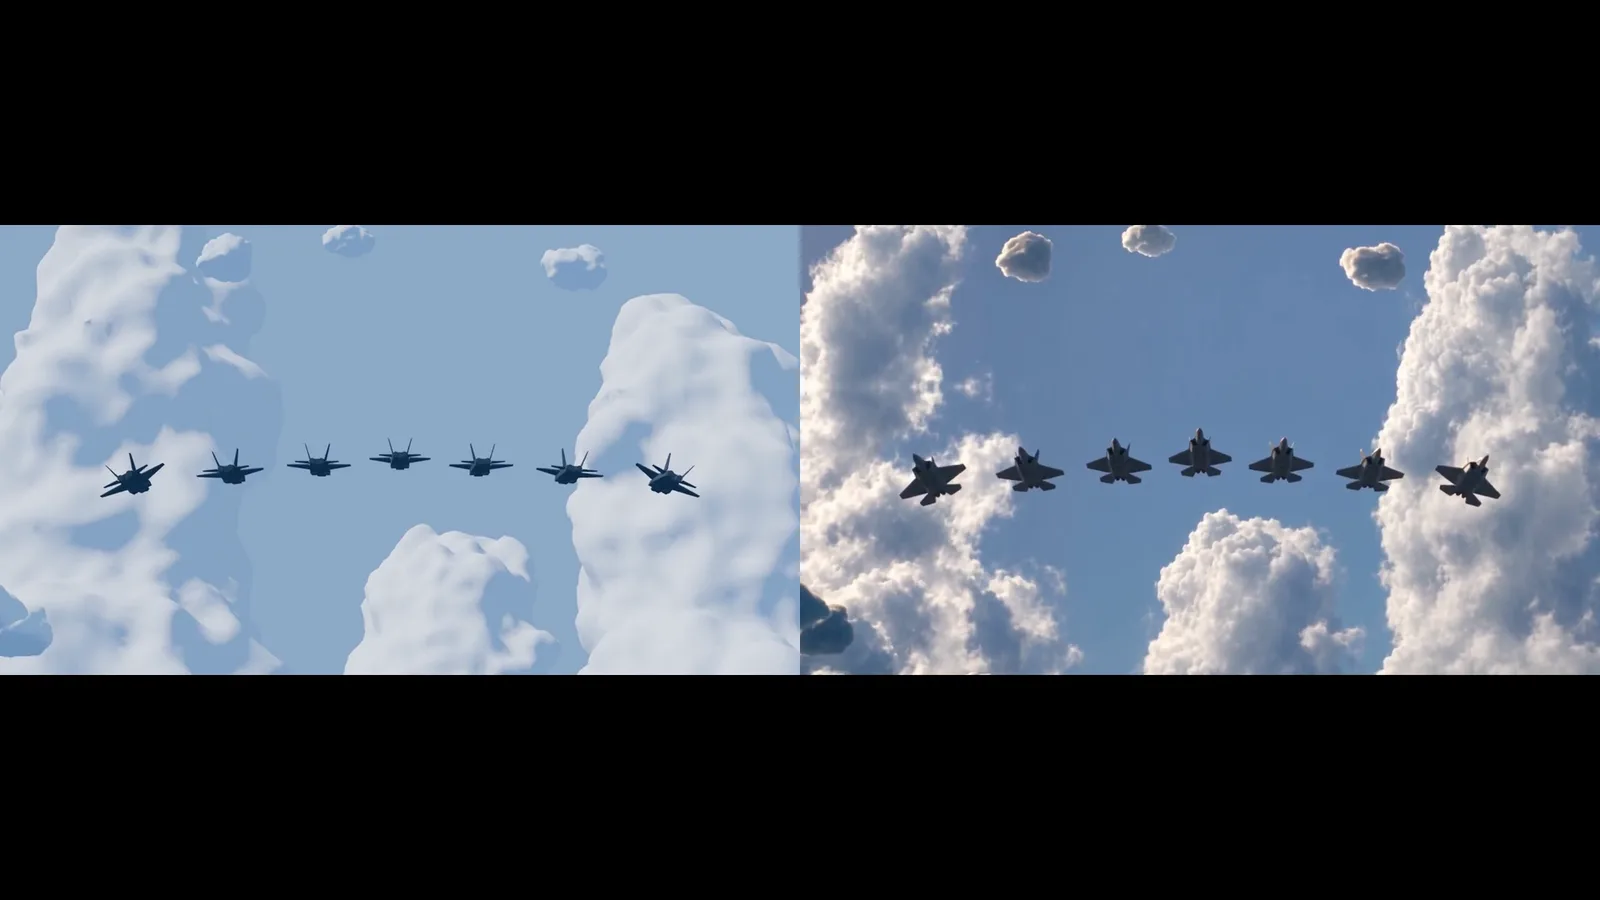
AI 영상 생성은 "그림 한 장 만들기"에 "시간"을 더한 기술입니다. 영상은 결국 그림 여러 장이 빠르게 넘어가는 것이라서, AI는 장면 하나하나를 그리면서 앞뒤 장면이 자연스럽게 이어지도록 함께 맞춥니다. 이 글에서는 AI가 영상을 만드는 원리, 글이나 사진에서 영상을 시작하는 세 가지 방법, 주제와 동작, 카메라 움직임까지 담는 프롬프트 요령, 그리고 AI 영상이 아직 자주 틀리는 부분을 차례로 설명합니다.
이미지 생성의 기본 원리(노이즈를 조금씩 걷어 내는 확산 모델)는 AI 이미지 생성의 원리와 좋은 프롬프트에 있습니다. 이 글은 그 위에 "움직임"을 더합니다.
한눈에 보기
| 항목 | 짧은 정리 |
|---|---|
| 영상 AI가 하는 일 | 글이나 사진을 받아 짧은 영상 클립 만들기 |
| 이미지 AI와 가장 큰 차이 | 여러 장면이 시간 순서대로 어긋나지 않게 이어져야 함 |
| 시작하는 방법 | 글로만, 사진 한 장에서, 첫 장면과 끝 장면을 정해서 |
| 프롬프트에 넣는 것 | 주제, 동작, 스타일, 카메라, 구도, 초점, 분위기, 필요하면 소리 |
| 아직 어려운 것 | 정확한 물리, 물체 상태 변화, 긴 영상의 앞뒤 일관성 |
비유: 플립북 그리기
공책 귀퉁이에 그림을 한 장씩 조금씩 다르게 그린 뒤 빠르게 넘기면, 공이 통통 튀는 애니메이션이 됩니다. 이것을 플립북이라고 합니다.
플립북을 잘 그리려면 두 가지가 필요합니다.
- 한 장 한 장이 그럴듯해야 합니다. 이미지 AI가 잘하는 일입니다.
- 넘길 때 자연스러워야 합니다. 공의 색이 갑자기 바뀌거나, 배경의 나무가 사라졌다가 나타나면 어색합니다.
AI 영상 생성의 어려움은 대부분 두 번째에서 생깁니다. 영상에서 한 장 한 장의 그림을 프레임이라고 부르는데, 보통 1초에 수십 장의 프레임이 지나갑니다. 몇 초짜리 짧은 클립이라도 수십에서 수백 장의 그림을 서로 어긋나지 않게 그려야 합니다.
원리: 영상을 작은 "시공간 조각"으로 나누기
OpenAI가 공개한 영상 생성 모델 Sora(API 제공이 2026년 9월에 끝난 서비스)의 기본 구조는 이렇습니다.
- 압축하기: 영상을 먼저 작은 요약 표현(잠재 공간)으로 압축합니다. 이미지 AI가 그림을 압축팩에 넣듯, 영상도 계산하기 쉬운 크기로 줄입니다.
- 조각내기: 압축한 영상을 시공간 조각(spacetime patches)으로 나눕니다. 화면의 한 부분(공간)과 짧은 시간 구간(시간)을 함께 묶은 조각으로, 영상을 가로, 세로, 시간 방향으로 자른 작은 블록입니다.
- 노이즈 걷어 내기: 노이즈 조각에서 출발해, 설명 글에 맞는 깨끗한 조각이 되도록 여러 번 고쳐 나갑니다. 이미지의 확산 모델과 같은 원리를 시간 방향까지 넓힌 것입니다.
이 구조에서는 사진을 "프레임이 한 장뿐인 영상"으로 보고 같은 방식으로 다룹니다. 사진과 영상을 한 틀로 배울 수 있다는 뜻입니다.
조각 하나하나가 공간과 시간을 함께 담고 있어서, AI는 "이 부분이 다음 순간에 어떻게 바뀌어야 하는지"를 한꺼번에 고려할 수 있습니다. 장면마다 따로 그린 뒤 이어 붙이는 방식보다 움직임이 자연스러워지는 이유입니다. 다만 회사마다 세부 구조는 다르고 공개하지 않는 부분도 많으니, 이것은 대표적인 방식 가운데 하나로 이해하면 됩니다.
시작하는 세 가지 방법
영상 AI에 무엇을 주고 시작하느냐에 따라 크게 세 가지로 나눌 수 있습니다.
| 방법 | 주는 것 | 좋은 점 | 알맞은 경우 |
|---|---|---|---|
| 텍스트 → 영상 | 설명 글만 | 가장 간단함 | 아이디어를 빠르게 시험해 볼 때 |
| 이미지 → 영상 | 첫 장면이 될 사진이나 그림 한 장 | 등장인물, 색감, 구도를 미리 정할 수 있음 | 원하는 장면이 분명할 때 |
| 첫·끝 프레임 | 시작 장면과 끝 장면 두 장 | 어디서 시작해 어디서 끝날지 정할 수 있음 | 두 장면을 자연스럽게 잇고 싶을 때 |
실제 모델을 예로 들겠습니다. Stability AI의 Stable Video Diffusion은 2023년 11월 연구용 미리보기로 공개된 이미지 → 영상 모델로, 이미지 모델 Stable Diffusion을 바탕으로 만들었습니다. Google의 Veo에는 첫 프레임과 마지막 프레임을 지정하는 기능과, 한 사람이나 캐릭터, 제품을 담은 참고 이미지를 최대 3장까지 넣어 영상에 반영하는 기능이 있습니다.
실전에서는 이미지 → 영상 방식이 특히 쓸모가 있습니다. 먼저 이미지 AI로 첫 장면을 여러 번 만들어 마음에 드는 것을 고르고, 그 그림을 움직이게 하면 결과를 예측하기가 훨씬 쉽습니다. 영상은 이미지보다 만드는 데 시간과 비용이 더 드는 경우가 많으니, 싸고 빠른 단계에서 방향을 먼저 정합니다.
좋은 프롬프트: 이미지에 "동작"과 "카메라"를 더하기
이미지 프롬프트의 뼈대가 주제, 배경, 스타일이었다면, 영상은 여기에 무엇이 어떻게 움직이는지와 카메라가 어떻게 움직이는지가 더해집니다. Google의 Veo 문서가 권하는 요소는 이렇습니다.
| 요소 | 뜻 | 예 |
|---|---|---|
| 주제 | 영상에 나올 사물, 사람, 동물, 풍경 | 작은 돛단배 한 척 |
| 동작 | 주제가 하는 일 | 잔잔한 바다 위를 천천히 나아감 |
| 스타일 | 영화 장르나 느낌 | 따뜻한 다큐멘터리, 공상과학, 필름 누아르 |
| 카메라 위치·움직임 | 어디서 어떻게 찍는지 | 하늘에서 내려다보는 항공 뷰, 눈높이 |
| 구도 | 화면에 얼마나 크게 담는지 | 넓은 화면(와이드 숏), 가까이 잡은 클로즈업 |
| 초점·렌즈 | 무엇을 또렷하게 보여 줄지 | 배경이 흐린 얕은 초점, 광각 렌즈 |
| 분위기 | 색과 시간대 | 해 질 녘 따뜻한 톤, 푸른 밤 |
두 예를 비교해 보세요.
- 부족한 예:
바다 위 배 - 나은 예:
해 질 녘 잔잔한 바다 위를 천천히 나아가는 작은 흰 돛단배, 하늘에서 내려다보다가 천천히 다가가는 항공 숏, 따뜻한 주황빛 톤, 다큐멘터리 느낌
앞의 예는 배가 움직이는지, 카메라가 움직이는지, 어떤 빛인지가 모두 운에 맡겨집니다. 뒤의 예는 영상 감독에게 콘티(장면을 순서대로 그려 둔 촬영 계획표)를 건네는 것과 비슷합니다.
알아 둘 카메라 용어
영화 촬영 용어를 조금만 알면 카메라를 원하는 대로 움직이게 하기 쉽습니다.
| 용어 | 뜻 | 느낌 |
|---|---|---|
| 달리 숏(dolly shot) | 카메라가 레일 위를 미끄러지듯 앞뒤나 옆으로 이동 | 다가가면 몰입감, 멀어지면 여운 |
| 팬(pan) | 카메라 자리는 그대로 두고 고개만 좌우로 돌리기 | 넓은 풍경을 훑어보는 느낌 |
| 항공 뷰(aerial view) | 드론처럼 높은 곳에서 내려다보기 | 규모와 장소를 한눈에 |
| 위에서 내려다보기(top-down) | 바로 위에서 수직으로 보기 | 지도나 요리 영상 같은 느낌 |
| 벌레 시점(worm's-eye) | 땅바닥에서 올려다보기 | 대상이 크고 웅장해 보임 |
| 궤도(orbit) | 대상 둘레를 원을 그리며 돌기 | 입체감, 제품 소개 느낌 |
한 클립에 카메라 움직임을 여러 개 넣으면 AI가 헷갈리기 쉽습니다. 한 클립에는 카메라 움직임 하나를 기본으로 삼고, 여러 움직임이 필요하면 클립을 나누어 만든 뒤 편집에서 잇는 편이 다루기 쉽습니다.
글로 적는 소리
요즘 일부 영상 AI는 소리까지 함께 만듭니다. Veo에서는 소리를 이렇게 적습니다.
- 대사: 말할 내용을 따옴표 안에 넣습니다. 예: 선장이 "곧 도착합니다"라고 말한다.
- 효과음: 소리를 분명하게 묘사합니다. 예: 타이어가 크게 끼익거리고 엔진이 으르렁거린다.
- 주변 소리: 장소의 소리 풍경을 적습니다. 예: 잔잔한 파도 소리와 멀리서 들리는 갈매기 소리.
AI 영상이 아직 자주 틀리는 것
아래는 OpenAI가 2024년 Sora 기술 보고서에서 밝힌 한계입니다.
| 한계 | 내용 | 예 |
|---|---|---|
| 물리 | 유리가 깨지는 것 같은 기본적인 물리 현상을 정확히 흉내 내지 못함 | 컵이 깨지는 모습이 이상하게 나올 수 있음 |
| 상태 변화 | 음식을 먹는 것 같은 상호작용에서 물체의 상태 변화가 늘 맞지는 않음 | 한 입 먹었는데 빵이 그대로일 수 있음 |
| 긴 영상 | 길어질수록 앞뒤가 맞지 않거나 물체가 갑자기 나타나기도 함 | 뒤로 갈수록 장면이 흐트러질 수 있음 |
이미지 AI의 한계(정확한 글자, 여러 장에서 같은 인물 유지)도 영상에 그대로 이어지고, 시간이 더해지는 만큼 더 도드라집니다. 그래서 다음 요령을 써 보세요.
- 짧게 여러 번: 긴 영상을 한 번에 만들기보다 짧은 클립 여러 개를 만들어 좋은 것만 골라 잇습니다.
- 첫 장면을 그림으로 먼저 정하기: 이미지 → 영상 방식으로 등장인물과 색감을 고정합니다.
- 복잡한 물리 장면 피하기: 물이 쏟아지거나 물건이 부서지는 장면은 여러 번 시도하거나, 카메라 각도로 가려서 표현합니다.
- 참고 이미지 활용: 같은 인물이나 제품이 여러 클립에 나와야 하면 참고 이미지를 함께 넣습니다.
AI 영상은 편집 프로그램에서 자르고 이어 붙이는 과정을 거치는 경우가 많습니다. AI는 촬영 담당, 사람은 감독과 편집 담당이라고 생각하면 됩니다.
책임 있게 쓰기
AI 생성 표시: Veo로 만든 영상에는 SynthID 워터마크(눈에 보이지 않게 넣는 AI 생성 표시)가 들어갑니다. 영상을 공개할 때는 AI로 만들었다는 사실을 설명에 밝혀 두면 보는 사람의 오해를 줄일 수 있습니다.
실존 인물과 사건: 영상은 사진보다 더 진짜처럼 보이기 쉽습니다. 실제 사람의 얼굴이나 목소리를 흉내 내거나, 일어나지 않은 사건을 실제처럼 꾸미는 영상은 만들지 않는 것이 기본입니다. 많은 서비스가 약관으로 이런 사용을 제한하므로 쓰는 서비스의 이용 정책도 확인하세요.
저작권: AI로 만든 영상의 권리가 누구에게 있는지, 기존 영화나 캐릭터를 닮게 만들어도 되는지는 나라와 서비스 약관에 따라 다르고 지금도 논의 중입니다. 상업적으로 쓰기 전에는 약관을 확인하고, 실제 상표나 캐릭터를 흉내 내는 요청은 피하는 편이 안전합니다. 자세한 내용은 AI로 만든 이미지·글의 저작권 기초에서 다룹니다.
정리
| 항목 | 정리 |
|---|---|
| AI 영상 생성 | 그림 여러 장을 시간 순서대로 어긋나지 않게 만드는 기술 |
| 원리 | 영상을 압축해 시공간 조각으로 나누고, 노이즈를 걷어 내며 만듦 |
| 시작 방법 | 글로만, 사진 한 장에서, 첫 장면과 끝 장면을 정해서 |
| 프롬프트에 넣는 것 | 주제, 동작, 스타일, 카메라, 구도, 초점, 분위기, 소리 |
| 조심할 점 | 물리와 긴 영상의 일관성, AI 생성 표시, 실존 인물, 저작권 |
함께 읽기
참고 자료
- OpenAI, "Video generation models as world simulators" (2024-02-15): https://openai.com/index/video-generation-models-as-world-simulators/
- Google AI for Developers, Gemini API "Generate videos with Veo": https://ai.google.dev/gemini-api/docs/veo
- Stability AI, "Introducing Stable Video Diffusion" (2023-11-21): https://stability.ai/news-updates/stable-video-diffusion-open-ai-video-model
- Google Research Blog, "High Fidelity Image Generation Using Diffusion Models" (2021-07-16): https://research.google/blog/high-fidelity-image-generation-using-diffusion-models/